- 「Efficient Net(画像認識)」について学びたいけど理解できるか不安・・・
- 「Efficient Net(画像認識)」についてどこから学んでいいか分からない?
- 「Efficient Net(画像認識)」を体系的に分かりやすく教えて!
「Efficient Net」は、2019年に開発された画像認識モデルであり、効率的なスケールアップの規則を採用することで、開発当時の最高水準の精度を上回り、同時にパラメータ数を大幅に減少した画期的な技術です。しかし、興味があっても難しそうで何から学んだらよいか分からず、勉強のやる気を失うケースは非常に多いです。
私は過去に基本情報技術者試験(旧:第二種情報処理技術者試験)に合格し、また2年程前に「一般社団法人 日本ディープラーニング協会」が主催の「G検定試験」に合格しました。現在、「E資格」にチャレンジ中ですが3回不合格になり、この経験から学習の要点について学ぶ機会がありました。
そこでこの記事では、「Efficient Net」を理解するための3つのポイントを解説します。
この記事を参考にして「Efficient Net」が理解できれば、E資格に合格できるはずです。
<<「Efficient Net」の3つのポイントを今すぐ見たい方はこちら
Efficient Net の概要
- AlexNet以降は、CNN(畳み込みニューラルネットワーク)モデルを大規模にスケールアップすることで精度を改善するアプローチが主流となった。(例:ResNet-18からResNet-200まである)
- 従来では、以下の変数(幅、深さ、解像度)を適当にスケールアップ
◦幅:1レイヤーのサイズ(ニューロンの数)
◦深さ:レイヤー数
◦解像度:入力画像の大きさ - 精度を向上できたものの、モデルが複雑で高コスト
↓
- 2019年に開発された Efficient Net モデル群は、効率的なスケールアップの規則を採用
- 開発当時の最高水準の精度を上回り、同時にパラメータ数を大幅に減少(詳細は次項)
- 補足)Efficientを直訳すると「効率的」という意味
Efficient NetとCNNモデルのスケールアップ
- ICML2019の論文で、新たなモデルスケーリングの「法則」が提案された。
- 幅(=width(ユニット数))
深さ(=depth(レイヤー数))
解像度(=resolution(入力画像の大きさ))
などを何倍増やすか?
⇒ 複合係数(Compound Coefficient)を導入することで最適化
参考論文:「EfficientNet:Rethinking Model Scaling for Convolutional Neural Networks」
解説:https://arxiv.org/abs/1905.11946 - Efficient Net では複合係数( Compound Coefficient)に基づいて、深さ・広さ・解像度を最適化→「小さなモデル」かつ高い精度を達成
- モデルが小さい(パラメータ数が少ない)→ 効率化(小型化と動作の高速化)
Efficient Net の性能
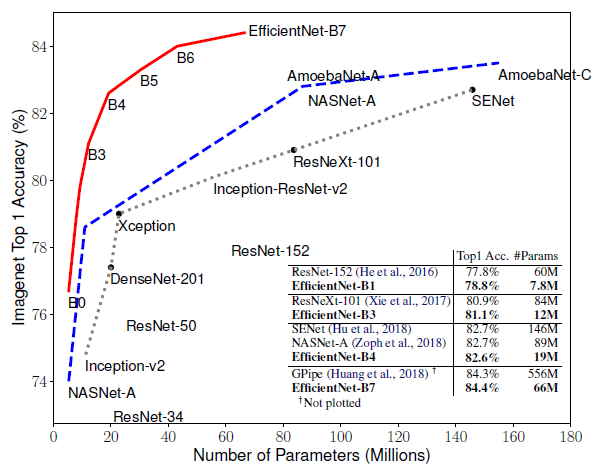
- 精度と効率の両側面で優れている。
- パラメータの数と計算量は数倍~1桁減少
- Res Net-50に比べてEfficient Net-B4は同程度の処理速度と計算量で精度が6.3%改善
- 転移学習でも性能を発揮(シンプルかつ簡潔な構造、汎用性が高い)
複合スケーリング手法の詳細
以下のどれも、ある程度まで増やすと精度の向上は横ばい
- Depth(d):
゜ネットワークの層を深くすることで、表現力を高くし、複雑な特徴表現を獲得できる。 - Width(w):
◦ユニット数を増やすことでより細かい特徴表現を獲得し、学習を高速化できる。
◦深さに対してユニット数が大きすぎると、高レベルな特徴表現を獲得しにくくなる。 - Resolution(r):
◦高解像度の入力画像を用いると、画像中の詳細なパターンを見出せる。
◦時代が進むにつれてより大きいサイズの入力画像が使われるようになってきた。
- 畳み込み演算のFLOPS(演算量)はd,w2,r2に比例
 学生
depth、width、resolutionが各々2倍になるとFLOPSは各々何倍になるのかな?
 著者
次のようになるよ!
depthが2倍→FLOPSは2倍
widthが2倍→FLOPSは4倍
resolutionが2倍→FLOPSは4倍
- 3つのパラメータDepth、Width、Resolutionは、単一の係数φで一様にスケーリング可能
- α、β、γはベースとなるモデルに対してグリッドサーチで求める定数
グリッドサーチとは・・・
引用元:DXCEL WAVE
探索対象のパラメータ候補を列挙し、その全ての組み合わせを照らし合わせ、最適な組み合わせを見つけ出す探索手法
φ:ユーザー指定パラメータ、モデルのスケーリングに使用できる計算リソースを制御する役割
depth:d = αφ
width:w = βφ
Resolution:r = γφ
s.t.α・β2・γ2 ≈ 2
α≥1,β≥1,γ≥1
出典元:https://arxiv.org/pdf/1905.11946.pdf
与えられた制約の中である目的関数を大きく、また小さくする解を求めること
畳み込み演算が計算コストを占領するので、wとrが2乗のオーダーで効いてくる。
⇒ d,w2,r2に比例するFLOPSは~(α・β2・γ2)φ倍にスケールする。
※原論文ではα,β2,γ2 ≈ 2 という制約を設けており、FLOPSは~2φで増加すると近似できる。
引用論文:EfficientNet:Rethinking Model Scaling for Convolutional Neural Networks
Compound Scaling Method(複合スケーリング手法)の目標与えられたリソース制約に対してモデルの精度を最大化すること
↓
最適化問題として定式化することができる。
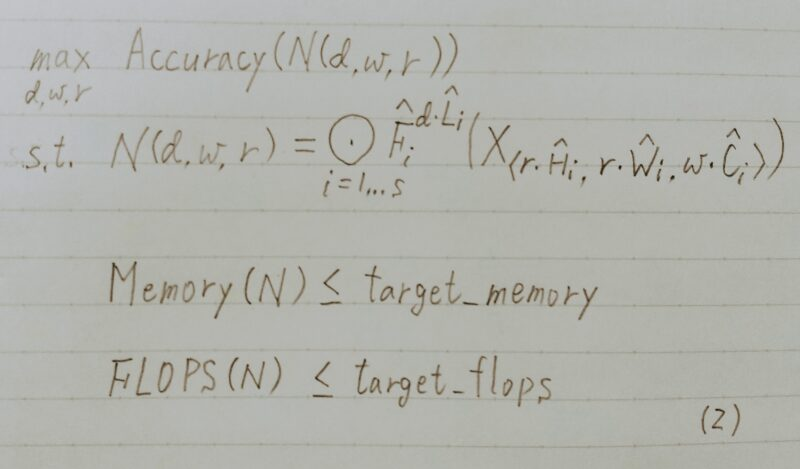
目標:精度を最大化すること(一番上の行)
N(d,w,r):ネットワークを表している。
d:層の深さをスケーリングするための係数
w:ユニット数をスケーリングするための係数
r:解像度をスケーリングするための係数
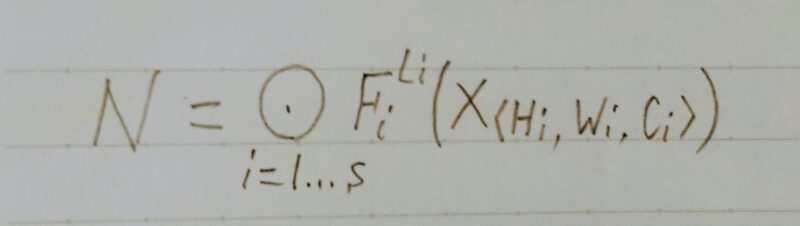
- この式はResNetなどのCNNを定義している。
- iは何番目のステージかを表していて、Fは畳み込み層を表し、Lはステージの中で何回Fを繰り返すかを表している。
- CNNの定義式に最適化問題を解くためにd,w,rを導入した式
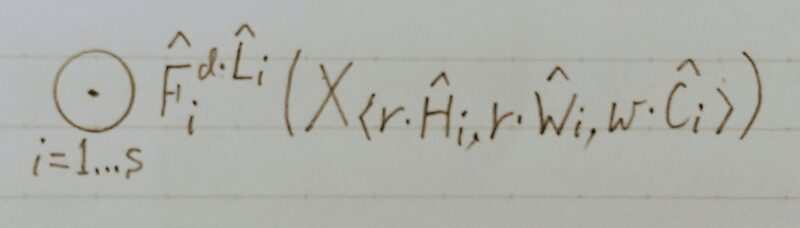
H:入力時のheight
W:入力時のwidth
C:チャンネル数
- 先程の式に、今回の最適化問題を解くためにd,w,rを導入する。
- Lにdをかけて層の深さを調整している。
- H,Wにrをかけて解像度を調整している。
- Cにwをかけてチャンネル数を調整している。
↓
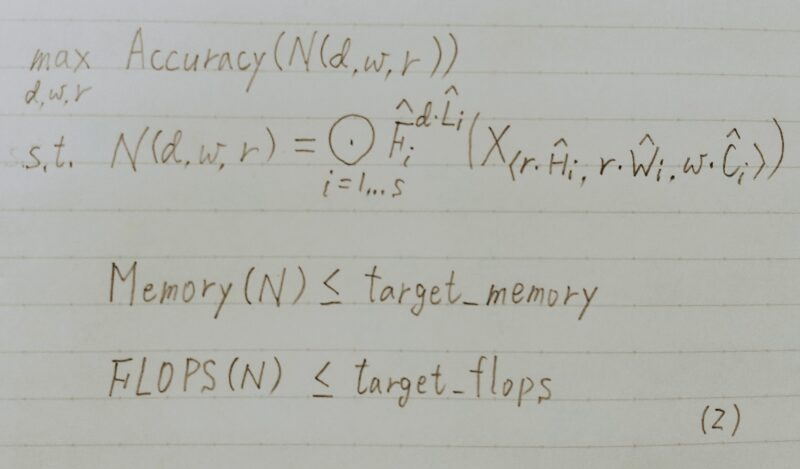
「メモリと畳み込み演算の計算量が設定した値以下」かつ「高い精度を達成」
↓
最適化
まとめ
【EfficientNetのポイント】
- Width(ユニット数)、Depth(レイヤー数)、Resolution(入力画像の大きさ)のバランスをとってスケーリングする効率的な手法を提案
- 開発当時の最高水準の精度を上回り、同時にパラメータ数を大幅に減少
- 計算リソースを2φ倍にできるのであれば、Depth、Width、Resolutionをそれぞれαφ,βφ,γφ倍にスケーリングすることができる。
最後まで読んで頂きありがとうございます。
皆様のスキルアップを応援しています!!
コメント